
我想大部分的人都知道 LLM 產生文字的方式是自回歸(Autoregressive),也就是每次只預測下一個 token然後把這個 token 接回輸入,再預測下一個文字,直到模型遇到 EOS 終止符為止。
這也讓我們知道LLM 其實就是根據目前為止的所有內容去預測下一個 token 最可能是什麼,你可以把 LLM 想成一個很龜毛的員工,每做一件事情之前,都要先把前面的工作紀錄重新翻一遍:
「下一個字是什麼?」
「等一下,我先看看前面講了什麼。」
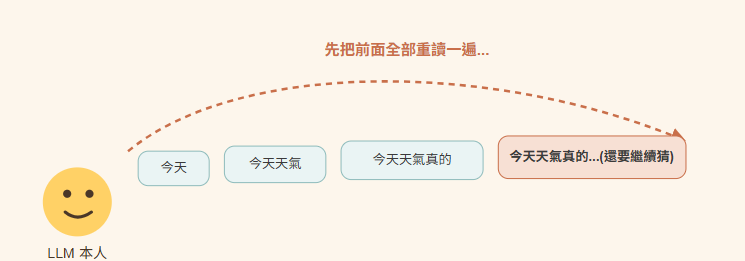
所以這也代表著當輸入序列越長其計算量就越大,每次預測下一個 token模型都要處理前面的內容一次,所以當你問了很多問題、或者 Agent 已經跑了很多輪對話,模型的回應速度就會明顯變慢。
也就是你跟它聊得越久,它的模型的記憶體與顯存使用量就越大,聊到最後可能不是你沒耐心,而是 GPU 先受不了了,而導致這一點的問題核心就是 Self-Attention的架構問題。
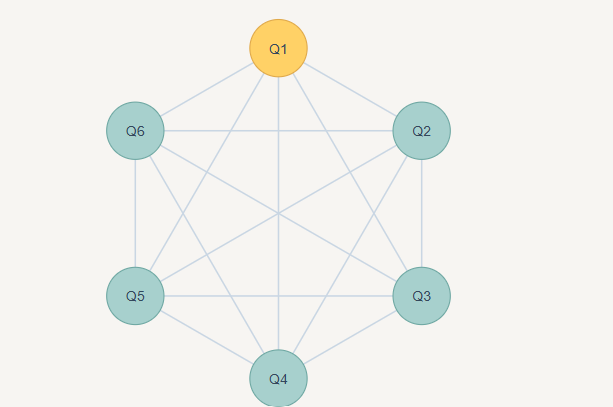
我們知道 Transformer 能力強大的關鍵之一,就是 Self-Attention 機制。在計算每個 token 時,模型都需要查看序列中的其他 token,決定應該對哪些 token 投入多少注意力。如圖中所示,假設輸入序列長度為 6,也就是 Q1 到 Q6,那麼在計算 Q1 時,就必須分別與 Q2~Q6 進行注意力計算。當序列長度持續增加,每個 token 都需要與更多 token 進行計算,因此整體計算複雜度會達到 O(n²),其中 n 代表序列長度。也就是說,當序列長度翻倍時,Attention 的計算量也會增加為原來的四倍。
所以 Context Window 越長不一定代表越爽,因為你塞得越多,模型也就越忙。
這時我們可以想一下,既然每一步都要重新查看前面的 token,那前面那些 token 的計算結果,是不是只要先 暫存(Cache) 起來,模型就不需要每次都重新做一次前向傳播?而這個方法,就是我們接下來要講的 KV Cache。
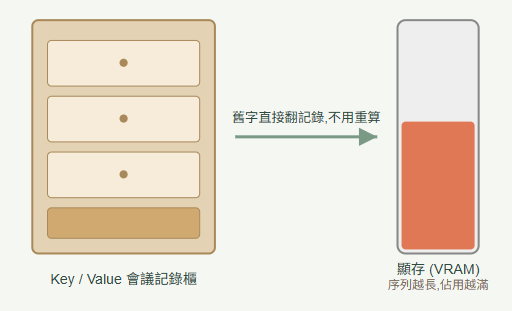
在 Self-Attention 裡,每個 token 都會產生 Key 和 Value 兩組向量。如果序列中舊的 token 內容沒有改變,那麼它們對應的 Key 和 Value 在後續步驟中其實也不會改變。這就很像我們平常開會一樣,與其每次都重新把整場會議開一次,不如直接翻閱之前留下的會議紀錄。總不能每次開會都先把上一次的會議重新開一遍吧。
所以有了 KV Cache 之後,每一步只需要計算新加入 token 的 Key 和 Value,舊 token 的結果則直接從快取中讀取,不需要重新計算。如此一來,就能大幅降低自回歸生成過程中的重複計算量。
不過這也代表著 KV Cache 本質上就是用顯存換取計算量,畢竟天下沒有白吃的午餐,序列越長需要保存的 Key 和 Value 就越多,所占用的顯存也會跟著增加。
回到我們要做的 Multi-Agent 系統,前面提到的幾件事會直接影響我們的架構設計。由於 Attention 有 O(n²) 的計算成本,加上 KV Cache 會隨著 Context 持續增長,因此當任務越來越長,單一 Agent 就需要處理越來越龐大的 Context,導致推論成本與資源消耗持續增加。
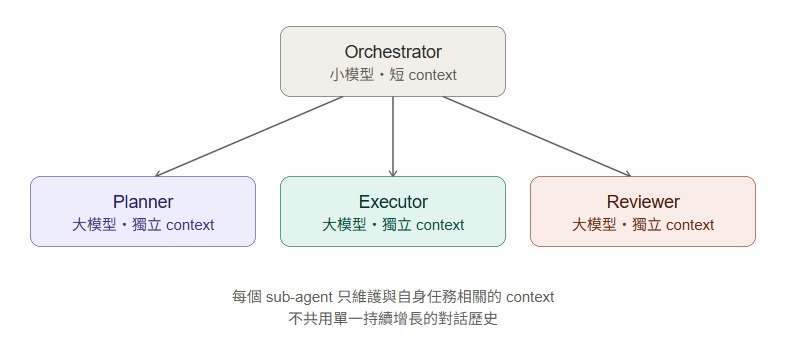
所以我們在設計一個大型的 LLM 架構時,通常需要把任務拆分成多個 Sub-agent。這樣做的好處,除了能讓不同 Agent 專注在自己的任務之外,也能更有效地控制 Token 使用量與推論成本,並在適當的情況下提升整體推論速度。
不過這也代表我們需要讓 Planner(負責規劃任務)、Executor(負責執行任務)、Reviewer(負責檢查結果)各自維護相對短的 Context,而不是把所有資訊都塞進同一個不斷增長的對話歷史中。因此,各部分的設計就非常重要。像是負責協調與分派任務的 Orchestrator(負責決定任務要交給哪個 Agent),可以使用較小的模型搭配較短的 Context;負責複雜推理的 Sub-agent,則可以使用較大的模型搭配較長的 Context……等等。這些我們都會在後面進行實作與討論,現在只需要先記得一件事:在 LLM 系統中透過架構設計降低單一模型需要處理的 Context 規模,減少複雜任務帶來的推論負擔。
今天我們從 Attention、KV Cache 一路講到 Multi-Agent 架構,這也是我們正式進入 Agent 設計的第一堂課。我相信看到這裡應該對Claude、GPT這類模型有些概念了。所以明天開始我們會繼續延伸今天的內容,當 Context 開始成為瓶頸時,我們該怎麼拆分任務,又該如何讓不同的 Agent 分工合作。
那我們明天見!


 iThome鐵人賽
 看影片追技術